claude.ai için ücretsiz tarayıcı eklentisi
Göndermeden önce bil.
Token Tahmini, yazdığın mesajın 5 saatlik ve haftalık Claude limitinin ne kadarını harcayacağını gönder tuşuna basmadan söyler. Hangi modelin ve hangi effort ayarının yeteceğini de gerekçesiyle gösterir; zamanla senin planından öğrenir.
EKSİK OLAN
Claude Code kullanımını gösteriyor. Sohbet ekranı göstermiyor.
claude.ai'de kullanımını görmek için Ayarlar → Kullanım sayfasına gitmen gerekiyor ve orası yalnızca şimdiye kadar ne harcadığını söylüyor. Limit çoğu zaman tam bir işin ortasında, beklenmedik bir mesajda bitiyor. Token Tahmini bunu sohbetin içine taşıyor ve bir adım öne geçiyor: mesajı göndermeden önce.
| Özellik | Ayarlar → Kullanım | Kullanım sayaçları* | Token Tahmini |
|---|---|---|---|
| 5 saatlik ve haftalık yüzde, yenilenme saati | ✓ | ✓ | ✓ |
| Sohbetin içinde, mesaj kutusunun yanında | – | ✓ | ✓ |
| Bu mesaj göndermeden önce ne kadar harcar | – | – | ✓ |
| Hangi model yeter, neden (gerekçeli öneri) | – | – | ✓ |
| Sohbet ortasında model değiştirmenin gizli maliyeti | – | – | ✓ |
| Kalan limitle kabaca kaç iş yapılır | – | – | ✓ |
| Senin planından ve alışkanlıklarından öğrenir | – | – | ✓ |
| “Bu mesaj neden bu kadar harcadı?” açıklaması | – | – | ✓ |
| Haftalık rapor, saat haritası ve kişisel öneriler | – | kısmen | ✓ |
| Önbellek ve yoğun saat geri sayımı | – | kısmen | ✓ |
* Ekim 2026'da sayfalarını incelediğimiz sekiz kullanım eklentisinin hiçbiri göndermeden önce mesaj başına tahmin ya da gerekçeli model önerisi sunmuyor; hepsi kullanımı gönderdikten sonra gösteriyor. Birinde önbellek, birinde yoğun saat geri sayımı, birinde ısı haritası var.
NE YAPIYOR
Limitini harcamadan önce, harcarken ve sonra.
Hepsi tarayıcında çalışır. Yeni sürümde eklenenler işaretli.
Göndermeden önce tahmin
Yazarken 5 saatlik ve haftalık limitin ne kadarının gideceğini %80 aralıkla gösterir. Ekleri, sohbet geçmişini, modeli ve düşünme ayarını hesaba katar.
Gerekçeli model önerisi
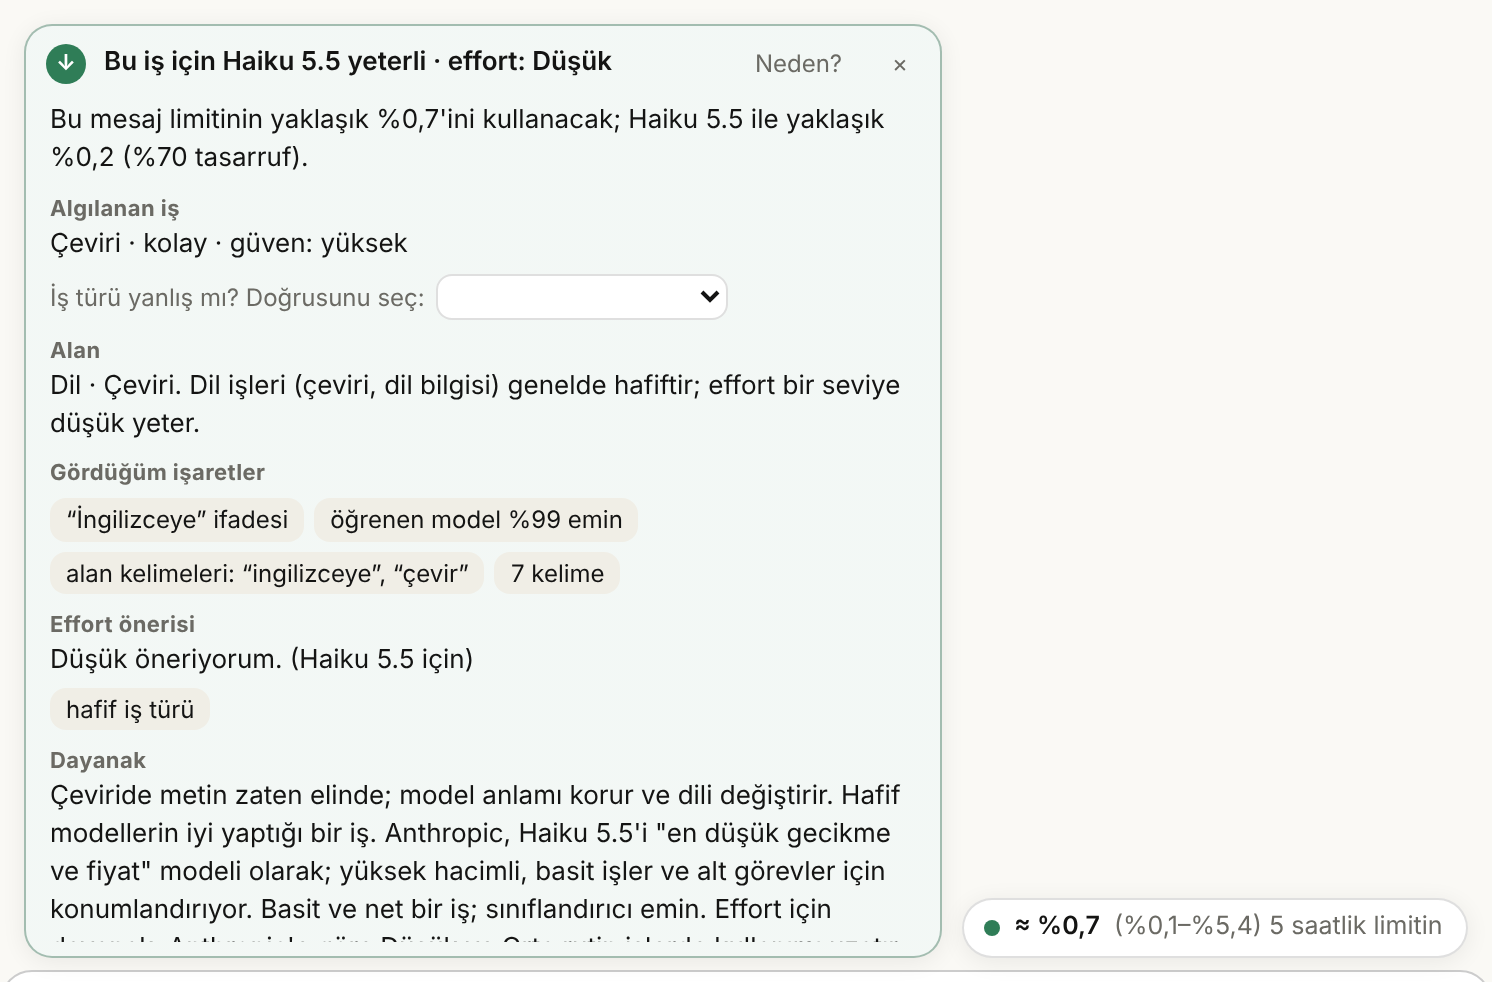
Hangi modelin yeteceğini, neye baktığını ve ne kadar kazandıracağını söyler. Emin değilse hafif model önermez.
Harcamanın dökümüYENİ
Maliyetin ne kadarı cevaptan, düşünmeden, geçmişten ve eklerden geliyor; kartta tek bakışta.
Önbellek ve yoğun saat geri sayımıYENİ
Sohbet geçmişinin kaç dakika daha ücretsiz okunacağını ve yoğun saatin ne zaman biteceğini gösterir.
Bu hızla ne zaman dolar?YENİ
Son bir saatteki hızına bakıp 5 saatlik limitin yenilenmeden önce dolup dolmayacağını söyler.
Devir özetiYENİ
Sohbet çok uzadığında, yeni sohbete taşımak için Claude'dan kısa özet isteyen hazır metni tek tıkla kopyalar.
“Neden bu kadar harcadı?”YENİ
Bir mesaj tahminin çok üstünde yerse sebebini söyler: uzun aradan sonra baştan okunan geçmiş, yoğun saat, uzun cevap ya da başka bir cihazda kullanım.
Haftalık raporYENİ
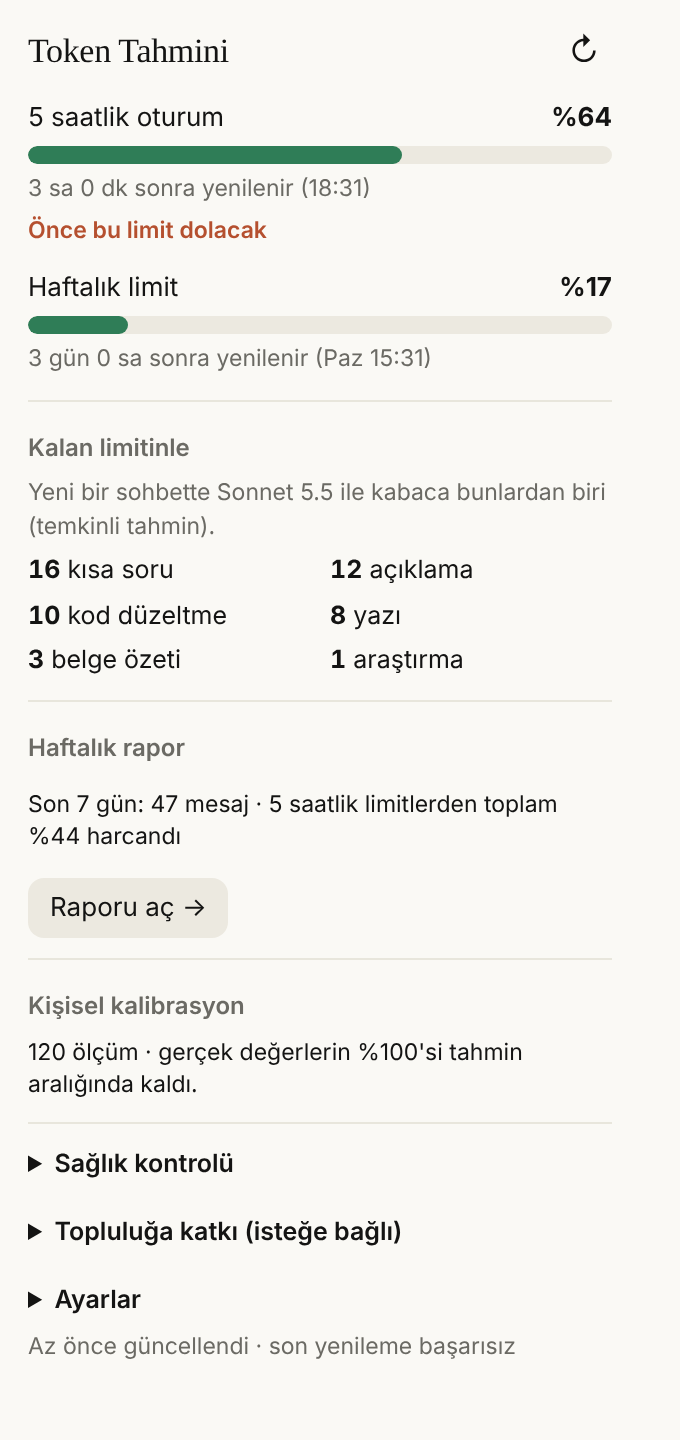
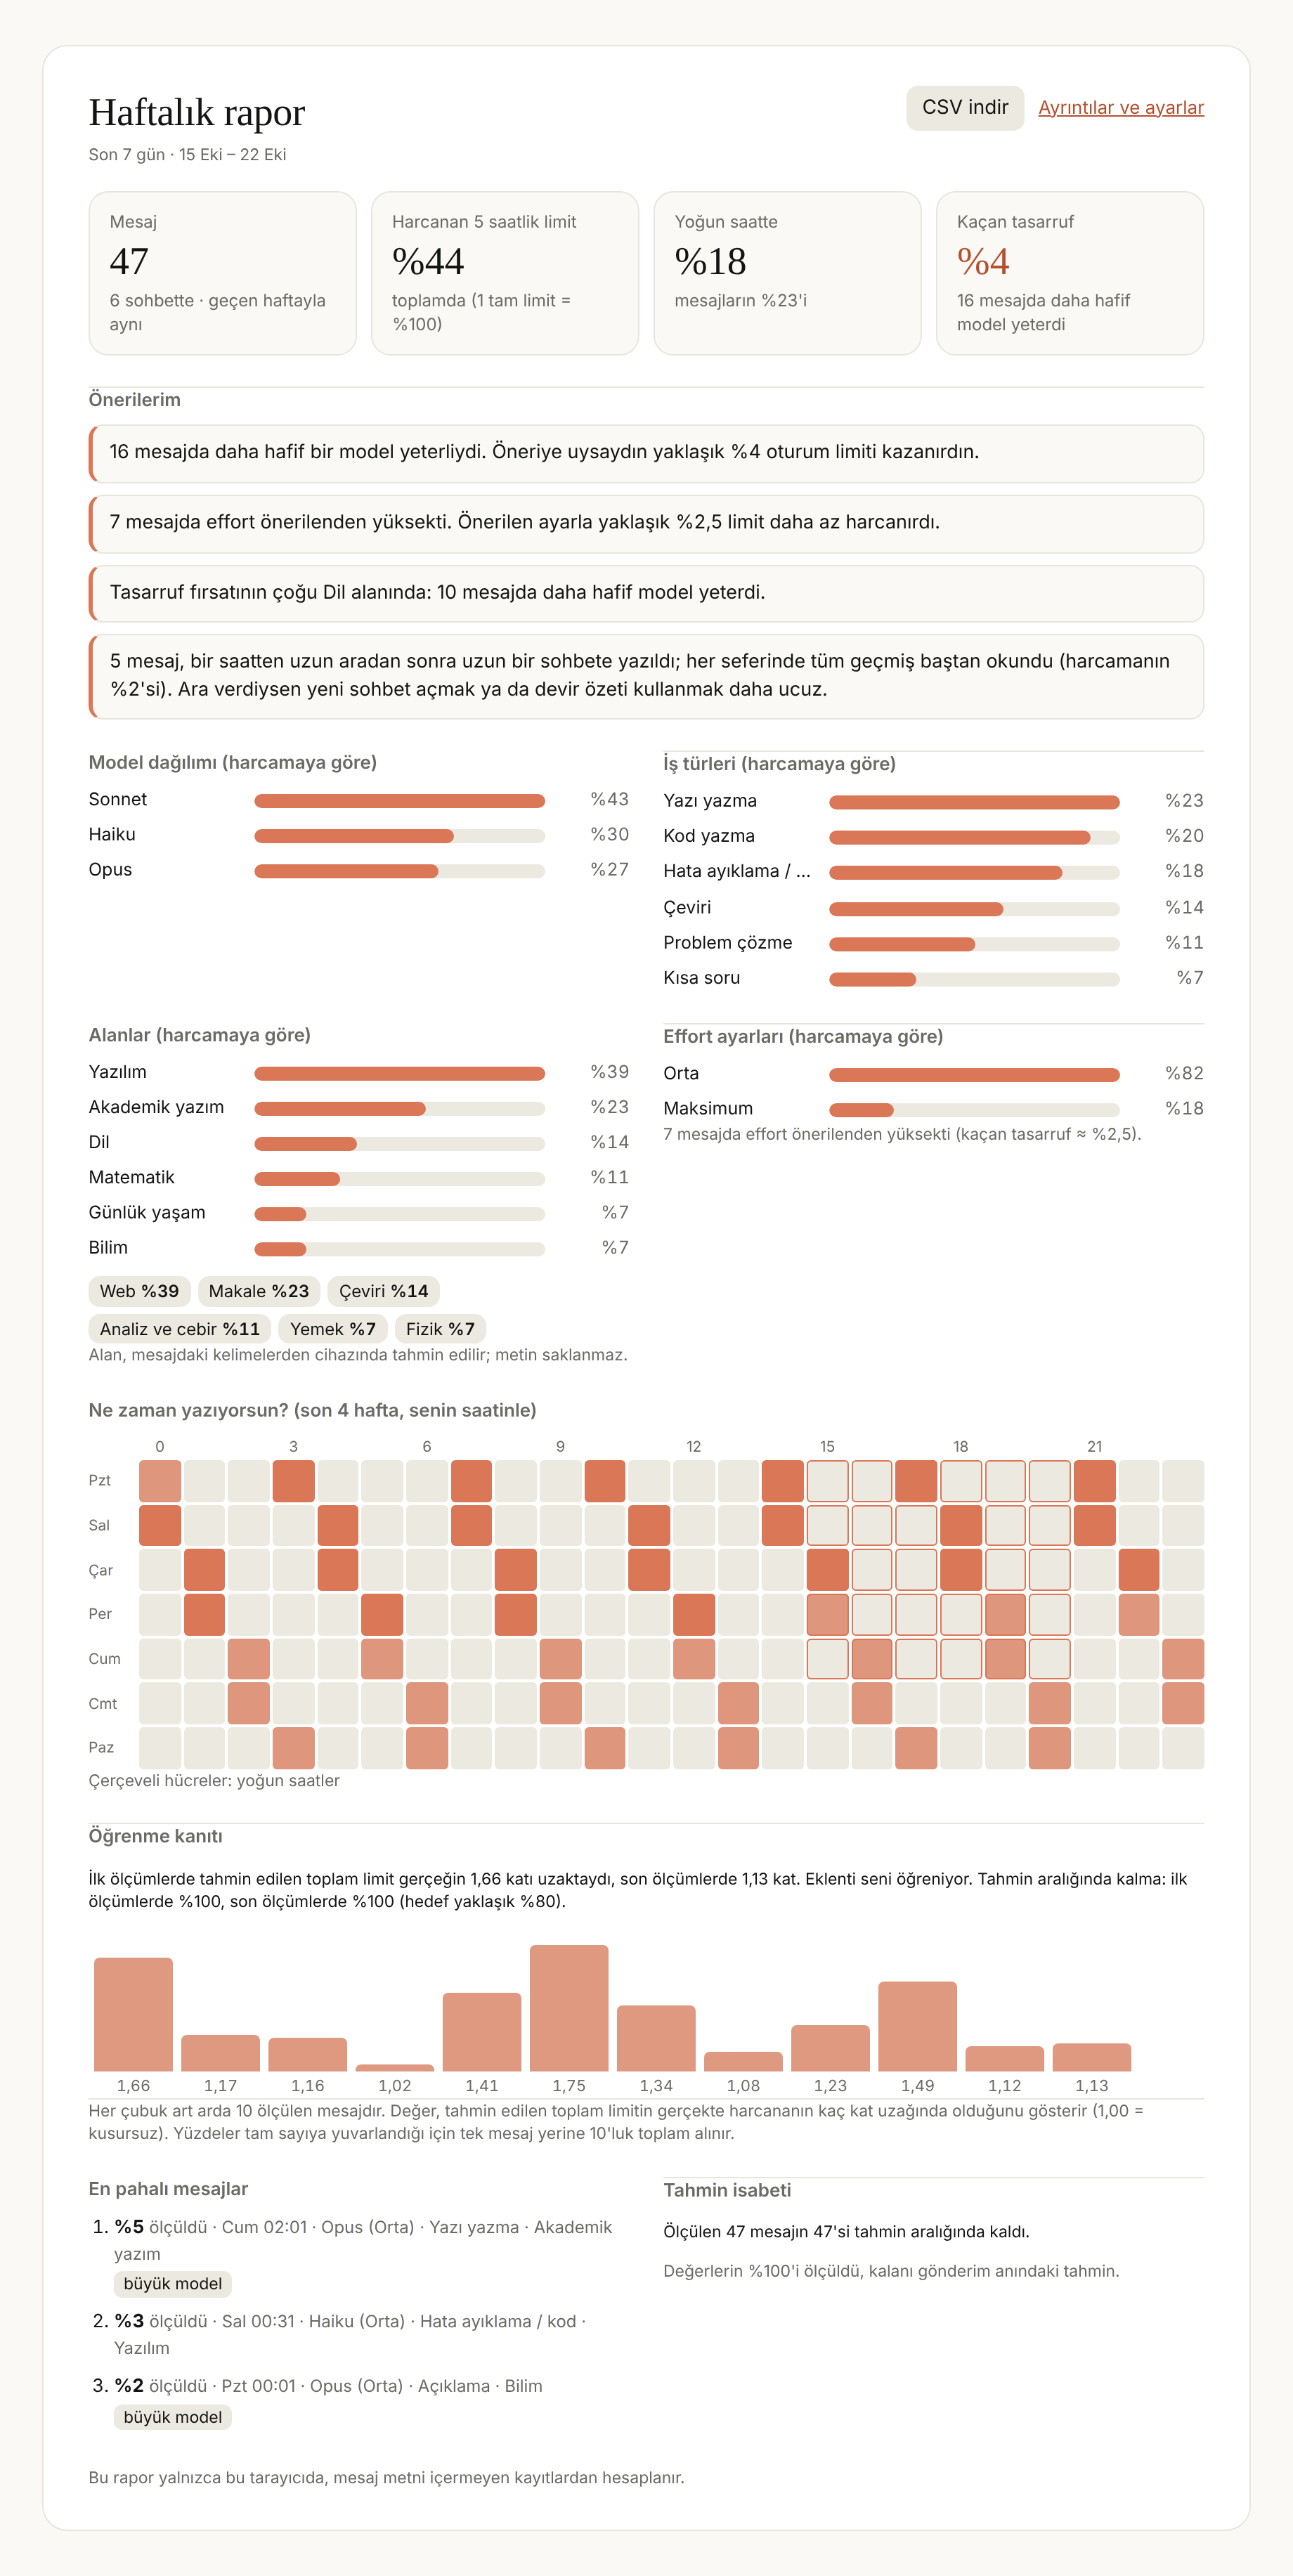
Mesaj sayısı, harcanan limit, yoğun saat payı, model ve iş dağılımı, saat haritası ve sana özel öneriler. Pazartesi sabahı bildirim, CSV dışa aktarma.
Cihazda öğrenen modelYENİ
İş türünü kurallar ve küçük bir öğrenen modelle birlikte tanır. Yanlışı düzelttiğinde bunu cihazında öğrenir.
Kişisel kalibrasyon
Her mesajdan sonra limitinin gerçekte nasıl değiştiğini ölçer; planının büyüklüğünü ve Claude'un sana verdiği cevap uzunluklarını öğrenir.
Konu alanını tanırYENİ
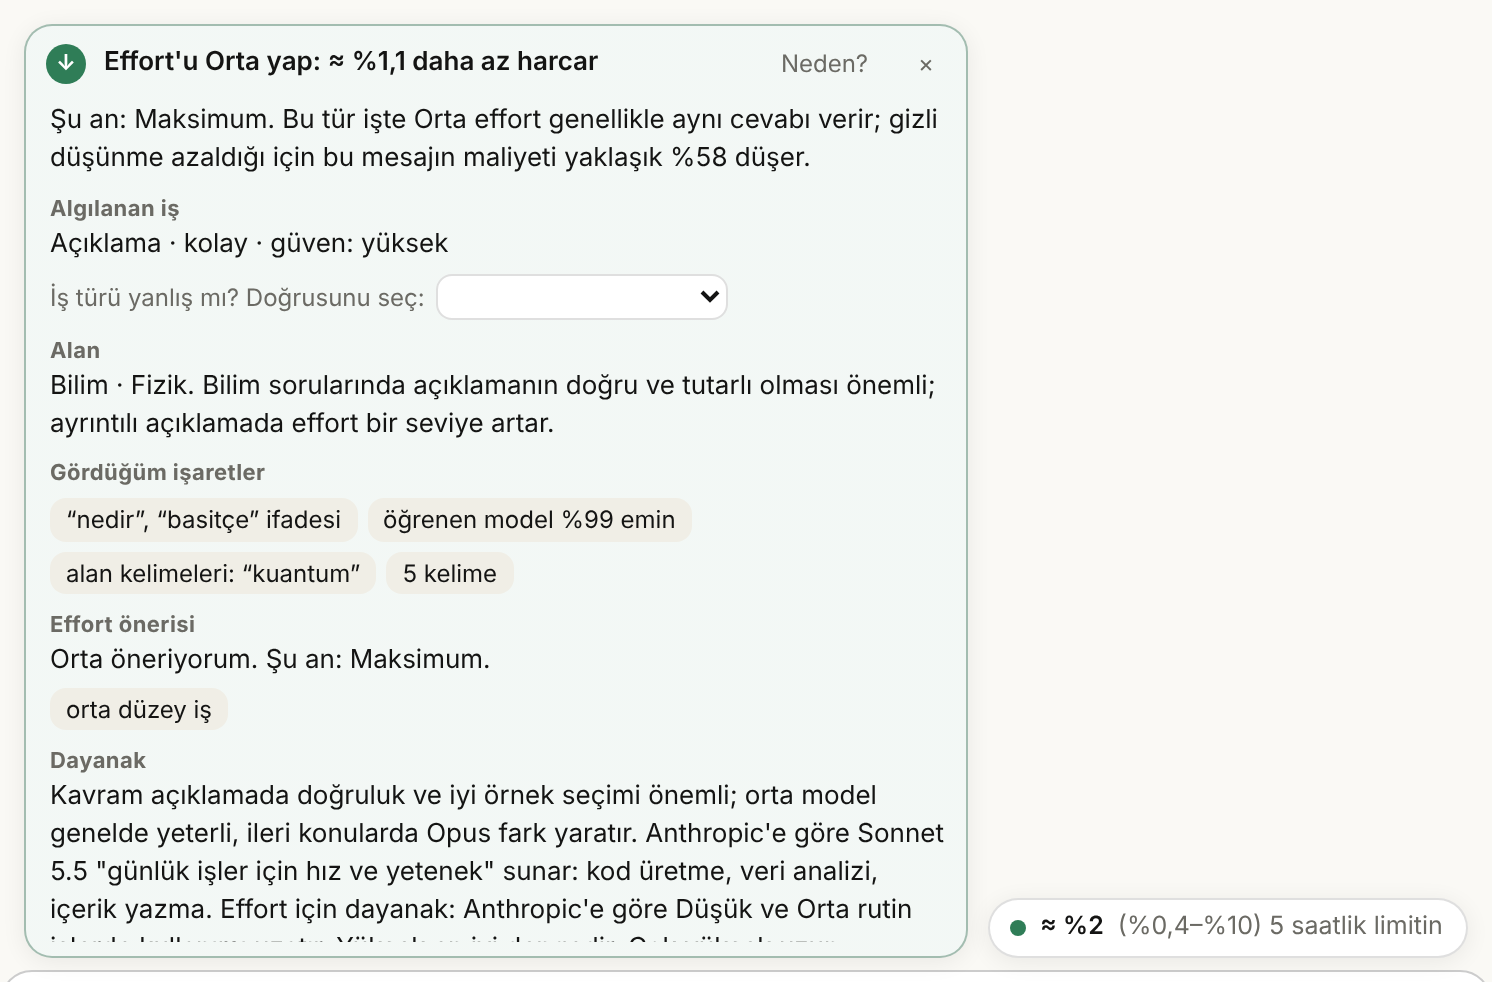
Mesajın konusunu 16 alan ve alt başlıkta (Bilim · Fizik, Mühendislik · Elektrik…) yaklaşık 2.600 anahtar kelimeyle tanır. Sağlık, hukuk ve para sorularında hafif model önermez.
Effort önerisiYENİ
Düşük'ten Maksimum'a: bu iş için hangi effort yeter, şu anki ayar fazlaysa ne kadar limit kurtarırsın. Modelin varsayılanını ve Çok yüksek seviyesini bilir.
Kelimeye değil işe bakarYENİ
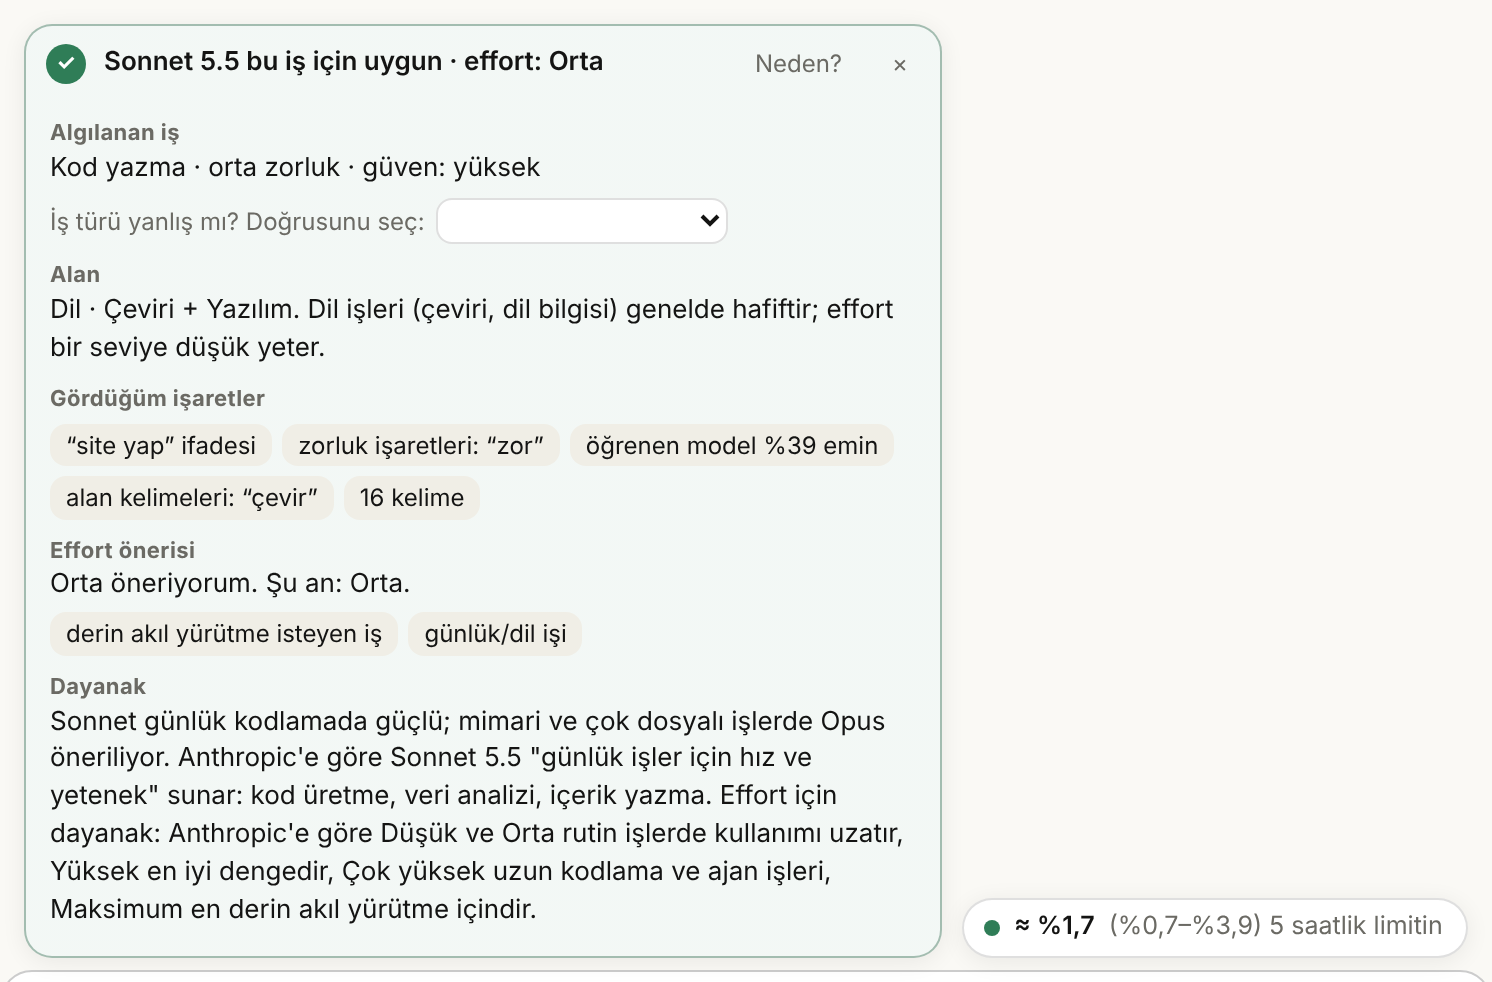
“Çeviri sistemi olan bir site yaptıracağım” cümlesi çeviri değil, yapım işidir. Eklenti bunu ayırt eder ve Haiku önermez.
Taşınabilir hapYENİ
Hapı sürükleyip istediğin yere koy. claude.ai'nin effort ya da model menüsü açılınca kendiliğinden çekilir; Alt + ok tuşlarıyla da taşınır.
Öğrenme kanıtıYENİ
Raporda, kendi ölçümlerinden tahmin hatasının zamanla düşüp düşmediğini görürsün. Düşmüyorsa bunu da söyler.
EKLENTİDE
Yazarken tahmin, gönderince ölçüm.
Mesaj kutusunun üstünde küçük bir hap ve gerekçeli öneri bildirimi; araç çubuğunda limitlerin, kalan limitle yapılabilecekler ve öğrenme durumu.
▶ Ayrıntılı tanıtım videosu (YouTube, 4 dk)
NASIL ÇALIŞIR
Fiyat listesi gibi değil, ölçü aleti gibi.
Anthropic limitlerin tam büyüklüğünü yayımlamıyor. Bu yüzden eklenti bir başlangıç tahminiyle açılır ve her mesajda gerçek kullanım yüzdesinin önce ve sonra nasıl değiştiğini ölçerek kendini düzeltir.
- w_model
- Modelin göreli fiyatı. Haiku, Sonnet, Opus ve Fable arasındaki fark limitte de aynı oranda görünür (varsayım, ölçümle düzeltilir).
- geçmiş
- Son bir saat içinde kullanılan sohbet önbellekten okunur ve limitten düşmez. Bir saat beklersen tüm geçmiş yeniden sayılır; eklenti bunu uyarır.
- cevap
- Cevap uzunluğu iş türüne göre bir dağılımdan gelir (CASTILLO veri seti, 12 iş türü). Bu yüzden tek sayı değil, %80 aralık gösterilir.
- 5 ×
- Çıktı tokenı girdinin beş katı fiyatlıdır. Düşünme (effort) tokenları görünmez ama sayılır.
- k
- “1 maliyet birimi limitin yüzde kaçı?” Planına özel. Her mesajdan sonra Gamma-Poisson güncellemesiyle öğrenilir; yoğun saatler için ayrı tutulur.
MODEL ÖNERİSİ
En hafif model değil, yeten en hafif model.
Hafif model önermek, pahalı model önermekten daha kötü bir hatadır: kötü cevap, tekrar sorman demek. Eklenti Haiku'yu yalnızca açıkça basit ve emin olduğu işlerde önerir; emin değilse en az Sonnet der. Dayanağı Anthropic'in model seçme rehberi, 60 örnekli öneri test seti (uygunluk %100, gerekenden hafif öneri 0) ve cihazda çalışan öğrenen model.
Göreli maliyet: API fiyatıyla orantılı varsayılır ve kalibrasyonla düzeltilir. claude.ai'de sistem talimatı ve hafıza bağlamı 100K tokenın üstüne çıkardığı için Haiku'nun uzun bağlam fiyatı geçerlidir. Uzun bir sohbette model değiştirmek, geçmişin yeni modelde baştan okunması demektir; eklenti bu durumda “bir sonraki yeni sohbette seç” der.
KONU VE EFFORT
Aynı soru, farklı konu: farklı model, farklı effort.
İş türünden ayrı ikinci bir eksen: mesajın konusunu 16 alan ve alt başlıkta tanır (cihazda, anahtar kelimeyle). Sağlık, hukuk ve para sorularında hafif model önermez ve effort'u en az Orta tutar. Bilim, matematik ve mühendislikte açıklamalarda effort'u bir seviye artırır. Şiir ve öyküde uzun düşünme kaliteyi pek artırmadığı için effort'u en fazla Orta bırakır.
Anahtar kelimeler her alan için kısaltılmış örneklerdir. Alanı bulamazsa “Genel” der ve öneri değişmez.
Dayanak: Anthropic'in effort belgesi ve destek makalesi. Düşünme maliyeti oranları (cevabın görünen uzunluğuna göre) eklentinin varsayımıdır ve kendi ölçümünle düzelir. Önerilen effort'un cevap kalitesini koruyup korumadığı ölçülmedi.
YAPAY ÖĞRENME
Kurallar başlatır, model öğrenir, sen düzeltirsin.
Mesajın ne tür bir iş olduğunu anlamak tahminin ve model önerisinin temelidir. Eski sürüm yalnızca kurallarla tanıyordu. Yeni sürümde kuralların puanları, cihazda çalışan küçük bir öğrenen modele girdi oluyor. Model 128 KB, internete bağlanmıyor, bir tuş vuruşunda çalışıyor.
İş türünü doğru tanıma: kurallar → kurallar + model. Hiç bakılmadan yazılmış 120 gündelik mesajda (aksansız, selamlı, yazım hatalı).
Tehlikeli hata: zor bir işi (kod, matematik, araştırma) basit iş sanmak. İki test setinde, 240 mesaj.
Gerçekten basit işlerde doğru Haiku önerisi. Yanlış Haiku önerisi 0 → 1 (“2350'nin %17'si”).
- Kişisel kalibrasyonHer mesajdan önce ve sonra okunan limit yüzdesinden planının büyüklüğünü, yoğun saat etkisini ve Claude'un sana verdiği cevap uzunluklarını öğrenir.
- Kişisel düzeltmelerÖneri bildiriminde “iş türü yanlış mı?” deyip doğrusunu seçtiğinde model cihazında güncellenir; 👍/👎 öneri sınırlarını ayarlar. Saklanan şey metin değil, ağırlık farklarıdır.
- Topluluk (isteğe bağlı)Öğrenilen değerlerin metin içermeyen özetini paylaşırsan, yeni kullanıcıların başlangıç değerleri ortalamayla değil gerçek ölçümlerle gelir.
Dürüst not: eğitim ve test mesajlarını da proje yazdı; gerçek kullanıcı mesajlarıyla doğruluk henüz ölçülmedi. Topluluk katkısı tam olarak bunun için. Cevap kalitesi (Haiku gerçekten yeterli miydi?) ölçülmedi.
KANIT
Zamanla öğreniyor mu? Ölçtük.
Gizli gerçek değerleri olan 200 yapay kullanıcı (her biri 120 mesaj) ve eklentinin gerçek tahmin ve kalibrasyon kodu. Her mesajda önce tahmin edilir, sonra gerçek görülüp öğrenilir. Aynı mesaj akışında öğrenmeyen bir kopya ve gerçek değerleri bilen kusursuz bir tahminci de çalışır.
Neyi kanıtlamıyor?
- Kullanıcılar yapay. Gerçek hesaplarda sonuç değişebilir; bu yüzden raporda “Öğrenme kanıtı” bölümü seni kendi ölçümlerinle denetler.
- Tek bir mesajın harcaması önceden bilinemez: cevabın uzunluğu ve gizli düşünme rastgeledir. Öğrenen tahmin bu rastgelelik tabanına (1,7×) kadar iner, altına inemez. Hedef toplamı ve aralığı doğru tutmak.
- İş türü tanımada kişisel düzeltmeler, 240 çeşitli mesajda ölçülebilir bir doğruluk artışı vermedi (%90 civarında kaldı). Düzeltmeler kendi tekrar eden kalıplarını düzeltmek içindir, genel doğruluğu artırmaz.
- Deney tekrarlanabilir: tests/learning-proof.mjs ve tests/classifier-learning.mjs.
TOPLULUK
Birlikte daha isabetli.
Anthropic limitlerin büyüklüğünü yayımlamıyor; her kullanıcı kendi planını ölçerek öğreniyor. Bu ölçümleri birleştirirsek yeni gelen biri ilk mesajından isabetli tahmin alır. Hiçbir şey kendiliğinden gönderilmez.
Nasıl katkı verilir
- Eklenti penceresinde Topluluğa katkı → Katkı özetini göster. İçinde yalnızca sayılar ve etiketler var.
- Kopyala ve formu aç, açılan forma yapıştır, gönder.
- Toplanan özetler birleştirilir; bir sonraki sürüm herkes için daha iyi başlangıç değerleriyle gelir.
Katkı formu ve 2 dakikalık anket proje sayfası açılınca burada olacak.
GİZLİLİK
Her şey senin tarayıcında hesaplanır.
Eklentinin sunucusu yok. Mesajların, eklerin ve sohbetlerin cihazından çıkmaz; hiçbir analitik ya da izleme yok. Yalnızca claude.ai'de, senin oturumunla çalışır.
Ne okur, neden
- claude.ai'nin kullanım sayfasının verisi: 5 saatlik ve haftalık yüzde.
- Açık sohbetin geçmiş uzunluğu: önbellek ve bağlam hesabı için (metin yerelde sayılır).
- Mesaj kutusundaki metin ve ekler: yalnızca token saymak için, yerelde.
- İzinler: depolama, alarm, bildirim ve yalnızca
claude.aiadresi.
KURULUM
İki dakikada kurulur.
Chrome Web Mağazası'ndan tek tıkla kurulur; Edge ve Brave'de de aynı sayfadan, Opera'da “Install Chrome Extensions” eklentisiyle. Elle kurmak istersen adımlar aşağıda.
- Sürüm zip dosyasını indir: indirme sayfası (yakında).
- Zip'e sağ tıkla → Tümünü ayıkla. İçinde doğrudan
manifest.jsonolan bir klasör oluşur. - Adres çubuğuna
chrome://extensions(Opera:opera://extensions) yaz, Geliştirici modu'nu aç. - Paketlenmemiş öğe yükle → ayıkladığın klasörü seç.
- claude.ai sekmesini yenile. Mesaj kutusunun üstünde hap belirir; yazmaya başla.
Güncellerken öğrendiklerini kaybetme
Eski sürümü kaldırmadan önce eklenti penceresinde Ayarlar → Verimi dışa aktar. Yenisini kurunca Verimi içe aktar ile geri yükle.
Bir şey çalışmıyorsa
Pencerede Sağlık kontrolü her adımın durumunu gösterir. Günlüğü kopyala ile hata bildirirken ekle; günlükte mesaj metni yoktur.
SINIRLAMALAR
Neyi bilmediğimizi de söylüyoruz.
- claude.ai'nin belgelenmemiş iç yapısına dayanır. Anthropic sayfayı değiştirirse bir güncelleme gerekir; sağlık kontrolü bunu hemen gösterir.
- İlk mesajlarda aralık geniştir; limit büyüklükleri başlangıçta kaba tahmindir.
- Model önerisi kurallar ve küçük bir öğrenen modelle yapılır; cevap kalitesi ölçülmedi. 👍/👎 ve iş türü düzeltmelerin önerileri sana göre ayarlar.
- Yoğun saatlerde (hafta içi 05:00–11:00 Pasifik) 5 saatlik limit daha hızlı dolar; Anthropic çarpanı yayımlamadı, eklenti ölçerek öğrenir.
- Aynı hesabı başka bir cihazda ya da Claude Code'da aynı anda kullanırsan ölçüm bozulabilir; aykırı değer filtresi çoğunu eler.
- Konu alanı tanıma anahtar kelimeye dayanır. Kurallar bittikten sonra yazılan, neredeyse kör 90 mesajlık sette %71'ini buldu, 1 yanlış alan; bulamayınca “Genel” der ve öneri değişmez. Effort önerisinin cevap kalitesini koruyup korumadığı ölçülmedi.
- Düşünme tokenları claude.ai'de hiçbir yerde görünmez; yalnızca kullanım değişiminden dolaylı öğrenilir.
- Arayüz 10 dilde, ama mesaj analizi (iş türü, konu alanı, model ve effort önerisi) şimdilik yalnızca Türkçe ve İngilizce mesajlarda çalışır. Diğer dillerde token ve limit tahmini yine yapılır (token sayımı dile göre ayarlıdır ama daha az örnekle ölçüldü); öneri gösterilmez.
SIK SORULANLAR
Aklına takılabilecekler.
Ücretli mi?
Hayır. Hesap açmak da gerekmiyor.
Mesajlarımı okuyup bir yere gönderiyor mu?
Token saymak için mesaj kutusundaki metni tarayıcında okur ama hiçbir yere göndermez. Eklentinin sunucusu yok; analitik ya da izleme yok. Haftalık rapor ve öğrenilen değerler mesaj metni içermez.
Tahminler ne kadar doğru?
İlk mesajlarda aralık geniştir, çünkü limit büyüklükleri başlangıçta kaba tahmindir. Eklenti her mesajda ölçerek daralır; simülasyonda tahmin hatası 20 mesajda 1,13 kata, 100 mesajda 1,08 kata iniyor. Pencerede kaç ölçümün aralığa düştüğünü görebilirsin.
Claude'un kendi kullanım ekranından farkı ne?
Ayarlar → Kullanım şimdiye kadar ne harcadığını gösterir. Token Tahmini göndermeden önce bu mesajın ne kadar harcayacağını, hangi modelin yeteceğini ve neden bu kadar harcandığını söyler.
Hesabıma bir zararı olur mu?
Anthropic'in resmî bir aracı değildir. claude.ai'nin kendi sayfalarının kullandığı kullanım verisini senin oturumunla okur; mesaj göndermez, ayarlarını değiştirmez, hiçbir işlemi otomatikleştirmez.
Hangi tarayıcılarda çalışır?
Chrome, Opera, Edge ve Brave (Chromium tabanlı, sürüm 116 ve üstü). Firefox sürümü yol haritasında.
Kaynak kodu açık mı?
Evet. Kod GNU AGPL-3.0 lisansıyla açık: okuyabilir, çalıştırabilir, değiştirebilir ve paylaşabilirsin. Değiştirilmiş bir sürüm dağıtırsan, onu da aynı lisansla ve kaynak koduyla yayımlamalı, telif bildirimini korumalısın. “Token Tahmini / Token Forecast” adı ve logosu lisansa dahil değildir; değiştirilmiş sürümler başka bir ad kullanmalıdır.
Mesajımda “çeviri” geçince neden Haiku önermiyor?
Eklenti kelimeye değil işe bakar. “Şunu çevir: …” bir çeviri isteğidir ve Haiku yeter. “Çeviri sistemi olan bir site yaptıracağım” bir yapım işidir ve en az Sonnet önerilir. Bunun için 15 tuzak cümle ve gerçek çeviri istekleri otomatik testte.
Zamanla gerçekten öğrendiğini nasıl görürüm?
Eklenti penceresi → Haftalık rapor → Öğrenme kanıtı. 30 ölçümden sonra ilk ölçümlerle son ölçümlerin hatasını karşılaştırır, düşmediyse bunu da yazar. Yapay kullanıcılarla yaptığımız deney yukarıdaki Kanıt bölümünde.
Hangi dillerde çalışıyor?
Eklentinin ve bu sitenin arayüzü Türkçe, İngilizce, Almanca, Fransızca, İspanyolca, İtalyanca, Portekizce, Rusça, Japonca ve Çince olarak gelir; dil ayarlardan seçilir. Mesaj analizi (iş türü, konu alanı, model ve effort önerisi) yalnızca Türkçe ve İngilizce mesajlarda yapılır. Başka bir dilde yazarsan token ve limit tahmini yine çalışır, öneri gösterilmez ve eklenti bunu sana söyler. Tanıtım videosu ve ekran görüntüleri Türkçe ve İngilizcedir; diğer diller İngilizce olanı görür.
YOL HARİTASI
Sırada ne var?
Projeye destek ol
Token Tahmini ücretsiz kalacak. Geliştirmeye devam etmesine katkı istersen: